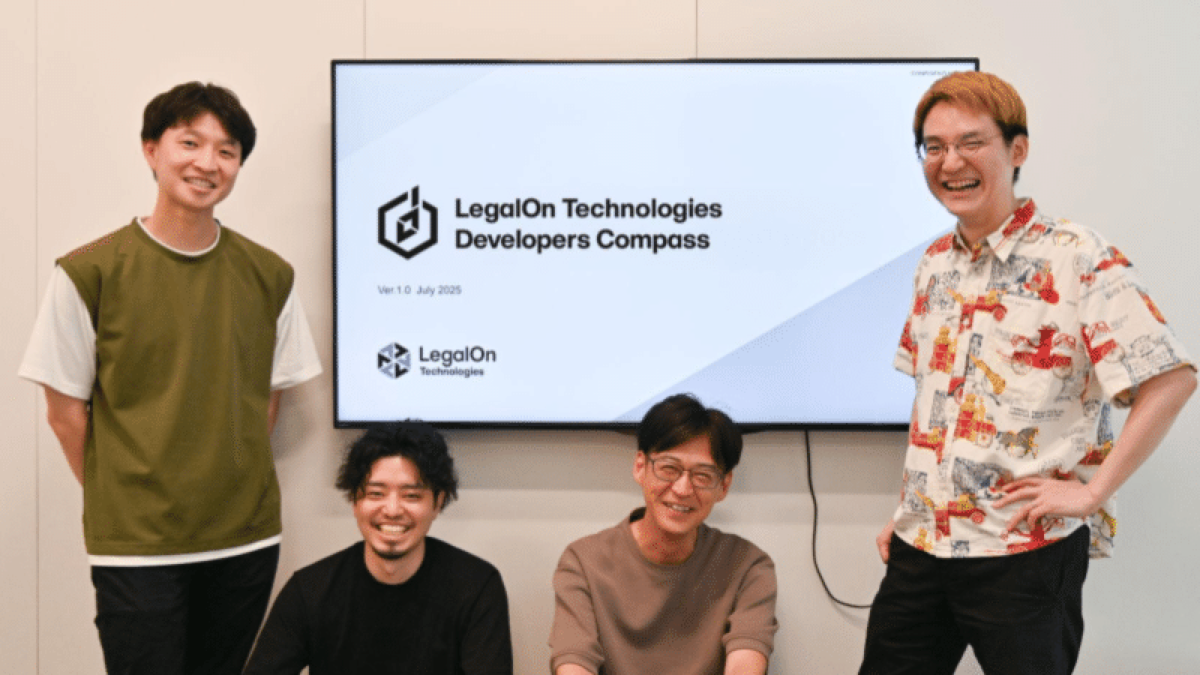


企业把AI编程助手铺到研发团队后,账单通常比演示阶段复杂得多。同样一次开发任务,需求是否清楚、代码库有多大、是否需要架构判断,都会改变模型的使用量。OpenAI在10月8日发布的LegalOn Technologies案例中,描述了这家法律科技企业如何在保留开发速度的同时管理Codex费用:按任务复杂度选择模型,限制默认使用的快速模式,再给不同业务设置不同预算。案例称,相对原先的使用方式,估算日成本下降约65%。这个数字很醒目,但不能脱离计算口径单独出售。
LegalOn最初让开发者较自由地使用高性能模型,把工具带进设计、实现和日常工作。规模扩大后,问题不是“AI有没有用”,而是有限预算是否被花在最需要强模型的环节。其内部AI开发卓越中心测试和监控不同型号,再把选择指南交给各团队。明确需求下的实现更多使用Luna,常规设计、分析与文档工作使用Sol,复杂架构和高级判断交给Astra。公司还把部门和个人月度使用上限纳入管理员控制。这些动作合起来,才构成成本变化的背景。
把任务分层,比一刀切降级更难也更有效
模型路由听起来简单,实际要先给任务划边界。写一个已定规格的接口,与决定系统如何拆分、如何处理权限和故障,是两种责任。前者可以尝试低成本型号,再由测试和评审把关;后者若因为节省调用费而选错工具,返工成本可能远高于模型价差。LegalOn案例可借鉴的不是某张永远有效的型号表,而是让工程师知道何时从轻量模型升级,何时必须请求人来做最终判断。
另一项容易被忽略的变化是快速模式。案例说,公司默认限制它,只在确有需要时允许个别请求。加速生成在紧急排障和探索中可能很值钱,但把每个日常任务都放进高价通道,就像让所有邮件都走加急快递。管理者需要同时看等待时间与总完成时间:若普通模式稍慢,却不拖延交付,省下的是纯成本;若限制让开发者频繁排队或重复提交请求,账单下降也可能掩盖生产率损失。LegalOn称团队通过并行推进任务维持了速度,这仍是该企业的经验,外部团队应自己测量。
企业内部的资源分配也不是按人平均。OpenAI案例写到,成熟业务被要求提升约20%的费用效率,而处在启动阶段的新业务获得较宽松预算。这种区分背后有商业逻辑:存量产品已经有收入与成本基线,管理者能比较投入产出;新产品还在找市场,不宜过早用统一上限压掉试错空间。若只把“部门预算上限”照搬过去,却不考虑业务阶段,最需要实验的团队反而可能先被限流。
65%的数字还要拆开读。来源称这是与此前GPT-5.5使用方式比较的估算日成本下降,来自模型选择、快速模式调整和预算安排的组合;它不是所有企业换用同一产品后的保证,也不代表单位代码成本必然下降65%。成熟业务约20%的效率改善,与整体估算日成本变化,口径也不同。把两个数字混为一谈,会制造“一个开关省掉大半账单”的错觉。财务负责人应要求同期间任务量、交付量、失败重试率和人工复核时间一并入账。
真正该追的指标,是功能交付而不是调用量
LegalOn案例里最值得注意的一句反而是保留意见:公司认为开发更快并不自动等于客户价值更高。这很符合实际。一项功能可以在两天内写出来,但如果用户不需要、质量不稳定或维护成本升高,节省的模型费与工时都无法变成更好的业务。衡量AI编程投入,至少要同时观察上线功能的使用情况、缺陷、回滚、开发者等待与总费用。只看生成代码行数或对话次数,很容易奖励无效工作。
研发主管若想验证类似策略,可以先选择两到三类高频任务,记录原有耗时和成本,然后在相同验收标准下比较不同模型组合。需求明确的修复、跨模块设计和故障调查应该分开,不能用一个平均数代表全部。测试集也要包含失败例:模型是否误改了不相关代码,是否忽略安全边界,工程师用了多久纠正。只有节省的费用和返工一起下降,路由才算有效。若便宜型号让资深工程师花更多时间收尾,账面上的低价没有意义。
这还是一份由供应商发布、基于单家客户实践的案例,不是跨行业独立实验。它说明LegalOn报告了怎样组织模型选择和预算,并给出其自身的估算结果;不能推出法律科技行业都将获得同等收益。与此同时,案例中所称型号和价格随产品更新可能变化,团队不应把2026年10月的配置当作长期固定处方。可复制的是分类、测量与反馈机制,而非某一天的型号名称。
对正在为AI开发工具扩容的企业,这个案例提供了一个务实的顺序:先明确任务与风险,再让模型能力和费用相匹配,最后看发布后的客户效果。最贵模型不是每次都必需,最便宜模型也不该成为默认的管理目标。真正降低成本的组织,往往不是减少了多少次调用,而是让有限预算更少地花在不需要它的地方。