IT之家 10月8日消息,Meta工程师在10月5日于捷克布拉格举行的Linux Plumbers Conference 2026(LPC 2026)上展示了一项名为CRAM(Compressed RAM)的实验性内存压缩方案。
該方案的目的並非簡單地替代 ZRAM 或 zswap,而是讓壓縮後的數據繼續以「內存」的形式存在,從而避免傳統 Swap 路徑中的軟體開銷。 LPC 官方資料顯示, CRAM 已經完成實際測試,在 TAOBench 和 FIO 的基準測試中可以達到接近原生 DRAM 的性能。
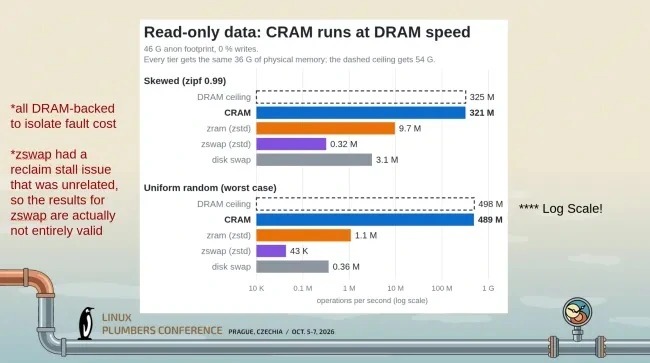
众所周知,目前 Linux 常見的內存壓縮方案包括 ZRAM 和 zswap。ZRAM 會在內存中創建壓縮塊設備,內核需要按照 Swap 路徑處理其中的數據;而 CRAM 的設計則不同,壓縮數據仍可保持頁表映射和頁緩存狀態,並支持 Cacheline 及 Byte 級訪問,因此讀取數據時無需像傳統方案一樣通過缺頁異常觸發軟件解壓流程。LPC 官方介紹稱,這也是 CRAM 對於 ZRAM、zswap 的關鍵特徵。
CRAM 的核心思路是将硬件压缩後的內存作為一種特殊的 NUMA 內存提供給 Linux,而不是模擬成塊儲存設備。
資料顯示,CRAM 會使用一個嚴格控制的私有 NUMA 節點,讓內核能夠繼續使用現有的內存管理機制,包括內存遷移、回收、降級、內存氣球機制、空閒頁報告以及 NUMA 內存均衡等。
這一設計是針對傳統內存壓縮方案中的軟體路徑開銷。对于只讀數據,CRAM 可以直接從壓縮內存中讀取,而無需先將數據換入普通內存再解壓。在這種模式下,CRAM 的表現可以接近原生 DRAM 的水準。
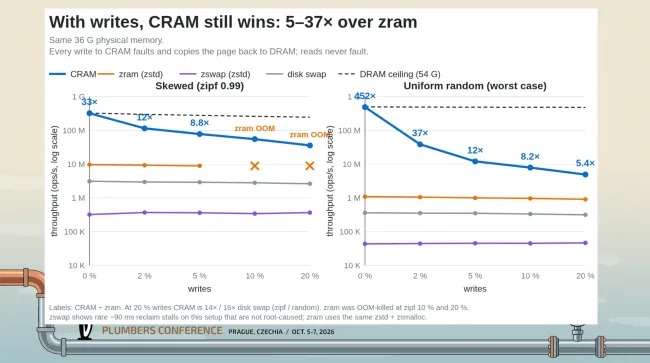
根據此次演示披露的測試數據,在純讀取場景下,CRAM在最壞情況下可達到每秒約4.89億次操作,而ZRAM約為每秒110萬次操作。按照這組數據計算,兩者差距約為444倍,而非452倍,因此官方“提升452倍”的說法可能需要在理想環境中才能實現。
當工作負載包含寫入操作時,CRAM的優勢會明顯縮小。由於壓縮數據無法直接在原位置進行修改,因此在寫入時需要通過缺頁處理將相應的Folio遷移回原生NUMA節點,再完成修改。
即便如此,素材所述最壞情況下 CRAM 仍達到 ZRAM 大約 5.4 倍的效能,但這一數字同樣應被理解為特定測試基準的結果,而非普遍的效能結論。
LPC 官方資料顯示,CRAM 目前仍屬於經過測試的內核服務原型,並非已經進入 Linux 主線的成熟功能。
Meta 工程師 Gregory Price 介紹稱,實現 CRAM 所需的大部分 Linux 核心基礎機制已經存在,目前需要進一步解決的是如何讓這種“實際容量與物理容量不一致”的內存設備符合 Linux 現有的內存模型。
IT 之家提醒:目前 CRAM 仍處於研發和社區討論階段,尚不能視為即將進入 Linux 主線的正式功能。此次公開的重點是探索如何利用現有的 Linux 内存管理機制來支持這種新型壓縮內存,而非宣佈一項已經完成標準化或商業化部署的產品。