

10月7日,OpenAI宣布开始在ChatGPT中推出GPT-6。比模型名称更值得观察的,是它同时推出的“Intelligent UI”:回答不再只能以一段文字、几张图片或一个表格出现,系统可以根据问题生成可交互的原生界面。对每天用ChatGPT查资料、比较方案或处理工作的人来说,这可能比参数规模的讨论更容易感知。但“开始推出”不等于所有账户、所有地区、所有功能已经同时可用;用户应该以自己账户中的实际入口为准。
从回答问题,到让用户直接操作答案
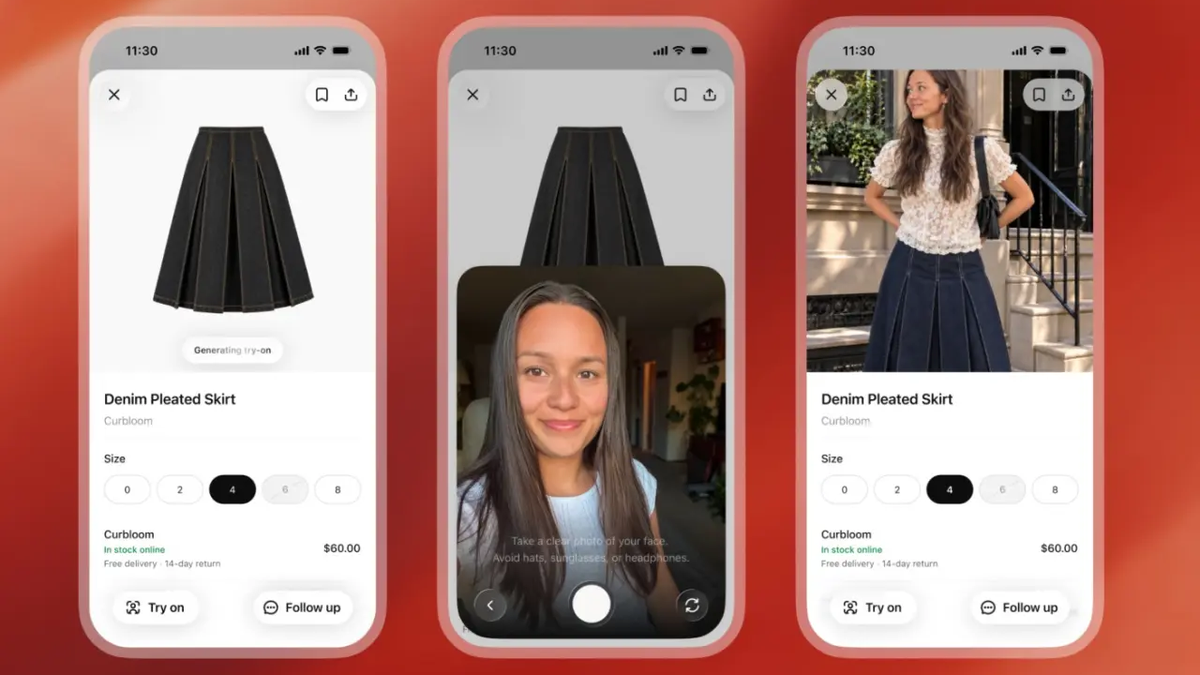
过去的聊天产品有一个熟悉的动作:用户提出问题,模型给出长篇说明,用户再把关键信息复制到表格、网页或其他工具里完成下一步。OpenAI这次展示的方向,是把其中一部分操作放回对话本身。比如比较选项时,回答可以呈现可调整的控件;解释概念时,用户可以在界面中改变条件,看结果如何变化。它强调的是信息的组织方式,而不是宣称模型替用户完成所有决策。
这也意味着,评估一次更新不能只看模型在基准题上多答对了多少。假设两款产品在知识问答上相近,其中一款能把复杂选项整理为可点击、可修改的结构,用户完成任务所需的时间可能更短;反过来,若界面设计掩盖了关键假设,漂亮的控件也可能使错误更难被发现。真正有价值的测试,应该是在真实任务中比较:从提出问题到核对依据、修正条件、拿到可用结果,一共需要多少轮往返。
根据OpenAI的发布说明,GPT-6于10月7日起面向Plus、Pro、Business和Enterprise用户逐步推出,Free与Go用户的推进安排从10月8日开始。Enterprise账户还涉及管理员配置,因此企业内部可见时间可能不同。这里有两个容易混淆的层次:一个是模型是否已在某个产品线发布,另一个是ChatGPT界面及相关交互能力是否已向某类用户开放。此前围绕GPT-6其他版本或开发工具的消息,不能自动视作此次ChatGPT体验已经覆盖全部用户。
对普通用户而言,最稳妥的做法不是为了新型号立即迁移全部工作流,而是挑选三类任务做对照。第一类是有明确事实答案的查询,核对来源与引用;第二类是需要比较方案的工作,检验界面是否保留取舍条件;第三类是需要反复修改的草稿,观察改动是否可追踪。若更新只让首屏更好看,却让依据更难核验,就谈不上真正提高效率。
对开发团队而言,原生交互界面也会改变产品边界。长期以来,不少应用把大模型当作生成文字的后端,再由前端团队设计每一个表单和步骤。若对话本身可以动态组织交互,部分低频场景也许不再需要预先造出完整页面。不过,权限管理、保存记录、审计日志和最终执行仍是独立问题。能在聊天里展示一个控制项,不代表系统就获得了操作外部账户的授权;更不能把模型生成的建议直接当作已经执行的动作。
热闹之外,仍要分清产品能力与事实责任
OpenAI发布材料中的演示和内部评测能够说明它想解决什么问题,却不是第三方对所有场景的最终结论。不同语言、设备、订阅等级和企业配置下,界面表现可能不同。尤其在金融、医疗或法律等需要严谨依据的场景,交互方式越顺手,越要看清模型依据是什么、条件是否被省略、引用是否指向原始材料。把一个不确定的判断装进精致的滑块,并不会让它自动变成事实。
还有一个现实问题是可复现性。同一句话在不同时间、不同账户上可能得到不同的界面结构。个人用户可以把这视为灵活性,企业则需要考虑留痕:当同事根据一个交互答案做出决定,团队以后能否还原当时输入了什么、看到了什么、改过哪些参数?如果不能,合规与协作成本可能抵消一部分效率收益。因此企业试点不妨先限定在可审查、可撤回的内部任务,而不是直接连接高风险动作。
这次发布也提醒市场,所谓“下一代模型竞争”正在从单纯拼回答质量,扩展到拼任务完成方式。模型推理、界面生成、工具接入和用户信任构成同一条链。前一环节的提升不会自动传到后一环节;回答更强,不一定意味着操作更可靠,操作更流畅也不意味着事实更准确。对厂商来说,决定留存的也许是整条链的稳定程度;对用户来说,最值得关心的是某个具体任务是否真的更快、更清楚、更容易复核。
截至本文撰写时,最准确的描述是:OpenAI已宣布并开始分批推出GPT-6的ChatGPT体验,以及与之配套的Intelligent UI方向。它既不是一张“所有人今日立刻可用”的通行证,也不是对其他开发产品同步升级的证明。接下来要看的,是分批开放后的真实使用反馈、各账户的功能边界,以及这些新界面能否在复杂任务中持续保留透明度。只有当用户不仅能更快得到答案,还能更容易发现答案哪里可能有问题,这次更新才算真正改变了工作方式。