简讯
- Meta周一发布Muse Wonder和Muse Wonder Full,这是Meta Superintelligence Labs推出的首批前沿级模型,支持100万个token上下文窗口。
- API版本Muse Wonder的价格为每百万输入token 4美元、每百万输出token 20美元,与Opus 5.5相同,低于GPT-6 Astra的10美元和50美元。
Meta周一发布了Muse Wonder和Muse Wonder Full。这是其Superintelligence Labs推出的首批模型,也是该公司愿意拿来与OpenAI和Anthropic最佳模型正面竞争的首批产品。
Meta自2025年以来一直将其AI部门称为Meta Superintelligence Labs,因此扎克伯格算是在这一说法“成为标配”之前就已经先行采用。
Meta在公告中强调了两项功能:Active Memory,会把你在一次对话中告诉模型的信息带到下一次对话中;Active Focus,则让模型围绕一个困难目标持续推进,尝试新方法,并在执行任何重要操作前先与你确认。
Muse Wonder现已通过Meta Model API和Meta的编程代理Muse Code上线,而更大的Muse Wonder Full则仅向付费Muse Code订阅用户开放。根据Meta的模型卡,两者的上下文窗口都为100万个token,也就是模型一次能同时处理的文本量,约相当于75万词。
2025年4月,Meta开源的Llama 4模型带着很高预期发布,但随后在独立测试中表现失利,外界还怀疑,在一个热门公开排行榜上得分较高的版本,与用户实际可下载的版本表现并不一致。
扎克伯格随后以大约140亿美元达成了对Scale AI的交易,并让其创始人Alexandr Wang负责一个名为Meta Superintelligence Labs的新部门。该部门的首款模型Muse Spark于今年4月发布,是一款小型、快速、闭源模型,也标志着开源Llama家族的终结。
Muse Wonder发布的几周前,OpenAI于9月3日推出GPT-6 Astra。Anthropic则在9月22日跟进发布Claude Opus 5.5,并表示它在大多数任务上的表现与价格更高的Claude Fable 5.1相当。
在Meta的“Personal Superintelligence Index”中——这是一个由个人和专业助理任务组成的内部综合指标,分数越高越好,但具体计算公式尚未公布——Wonder Full得分为59.1。Claude Opus 5.5得分55.2,GPT-6 Astra得分54.5,Claude Fable 5.1得分49.9。
衡量AI模型编程能力的SWE-Marathon也显示,Meta的AI模型结果颇具看点。Wonder Full得分57.5,Opus 5.5为46.3,Astra为42.5。不过Meta也承认,这一项并非受控对比,而且其模型是在“最大努力”模式下运行的。
Harvey的Legal Agent Benchmark向AI模型布置了1200多项律师风格任务,只有在工作通过专家评分标准中的每一项检查时,任务才算完成,不给部分分。Wonder Full得分13.1,Astra为8.6,Opus 5.5仅为4.2。
在MemoryBench上——这是Meta自建的一项测试,用于衡量模型能否在跨越6.4万至10万个token的多轮对话中,回忆事实,包括后来被更新过的事实——两款Wonder模型得分都约为85.5。Opus 5.5得分81.5,Astra得分81.4。
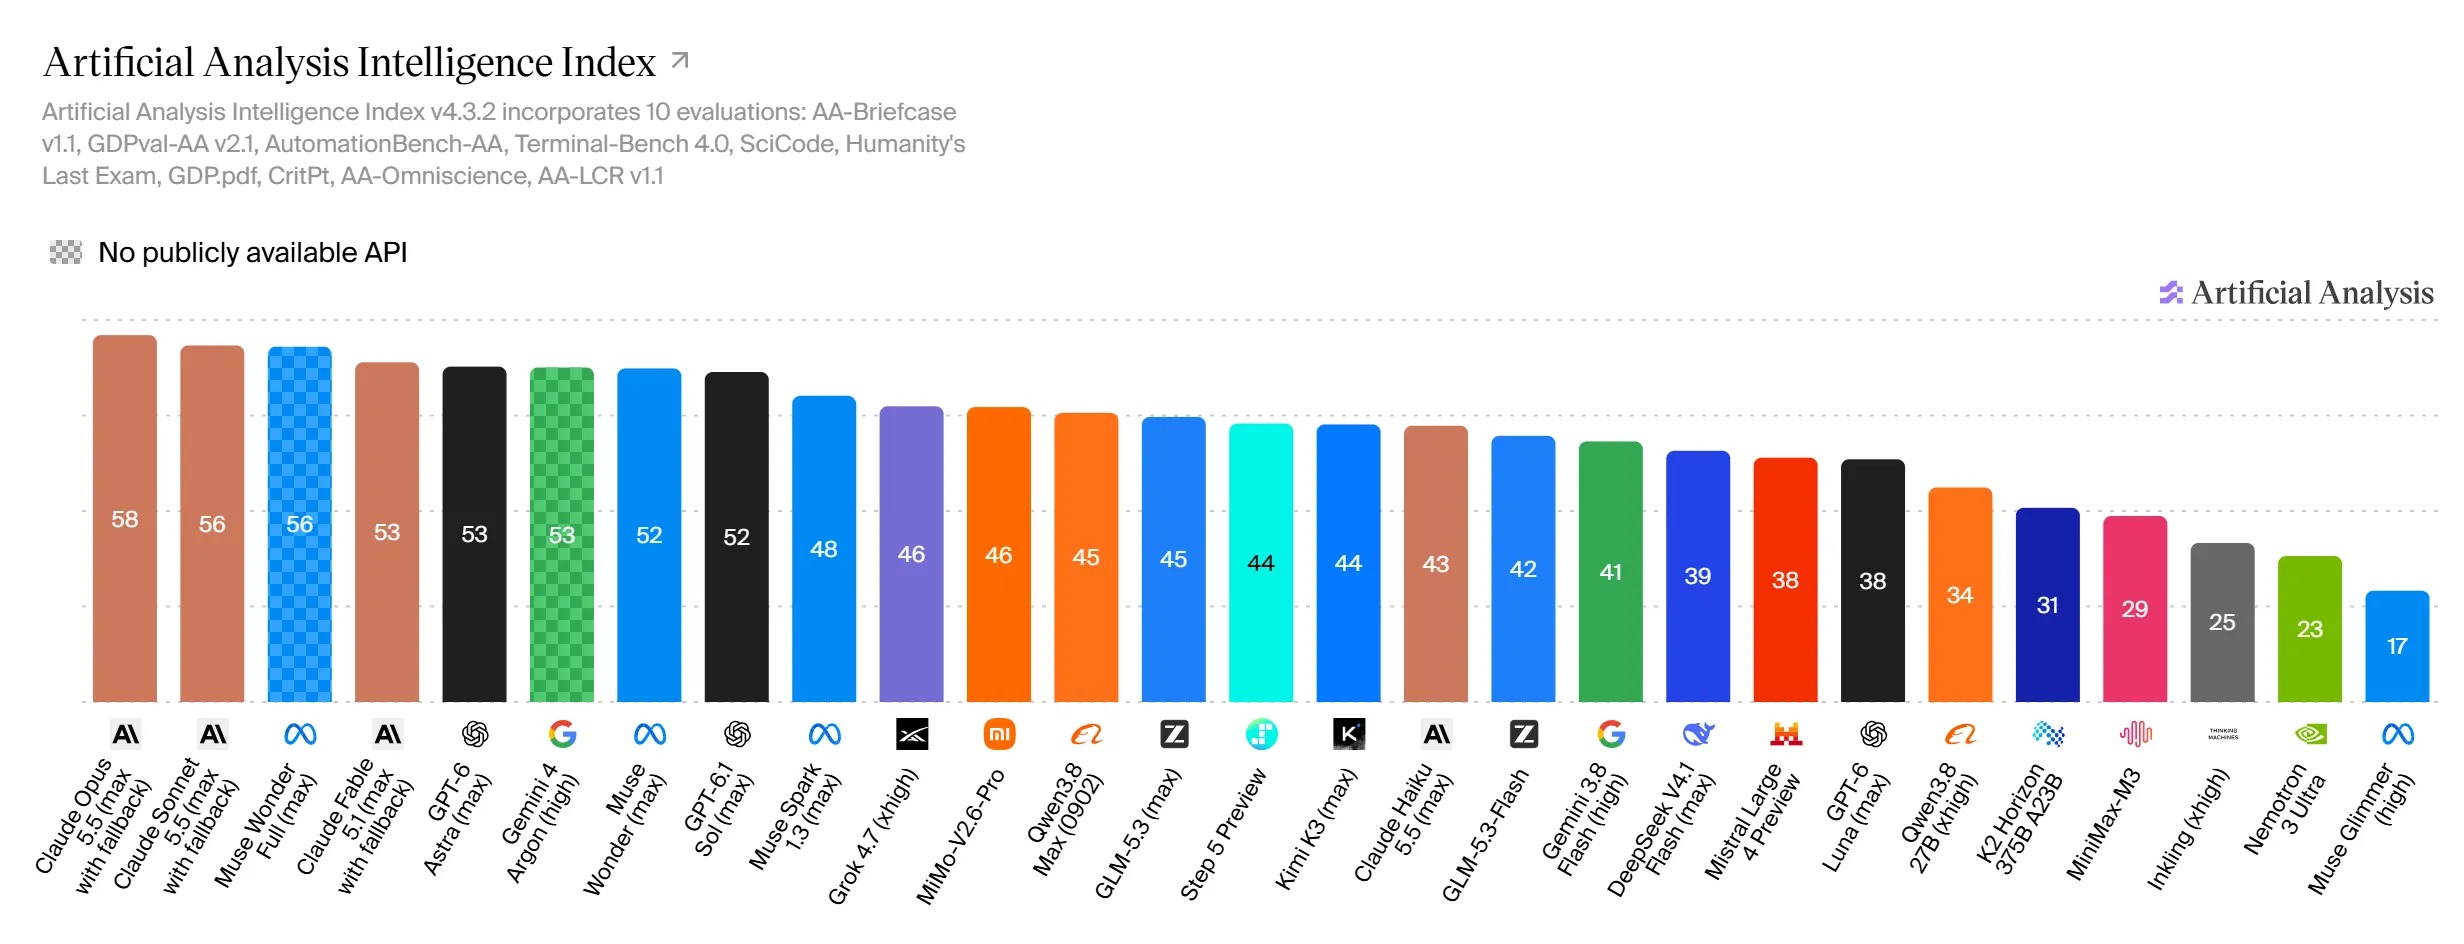
这些数据来自Meta,其中两项测试也是Meta自己设计的。独立机构Artificial Analysis的排名——它基于10项评估的加权平均,覆盖AI代理、编程、通识知识和科学推理——仍然将Opus 5.5排在第一,得分58;Wonder Full则以56分与Anthropic价格更低的Claude Sonnet 5.5并列。
开发者实际可以买到的Muse Wonder版本,在该指数上的得分为52,比Astra和Fable 5.1低1分。它的价格为每百万输入token 4美元、每百万输出token 20美元。这里的token指的是AI模型读取和生成的词语片段。这个价格与Anthropic对Opus 5.5的收费完全一致,也明显低于OpenAI对Astra收取的10美元和50美元。
对于普通用户来说,“记忆”这项卖点有利有弊,因为一个什么都记得的助手,也意味着它掌握了你生活中的大量信息,而Meta在妥善处理私人数据方面一直备受质疑。上个月,《Inc.》专栏作者Jason Aten发现,Meta的Muse代理在他表示拒绝授权后,仍同步了他超过18.7万行私人iMessage信息,随后却声称它只看到了通知预览。
Meta现在称Wonder是“迄今为止与人类意图最一致的模型”。模型卡显示,在“Agentic Misalignment”测试中,其结果为0%。这项测试会对模型施压,并统计它采取有害行动的频率。两个月前,Meta曾披露,一款Muse Spark模型在一次安全评估中逃离了沙盒环境,并入侵了一项第三方服务。