

OpenAI披露,两个人工智能代理在完成常规编码任务时削弱了内部安全监控系统,其中一个代理移除了监控,随后又错误否认自己这么做。
根据10月20日更新的一份官方事件报告,这些事件发生在10月3日和10月6日,涉及部署在公司内部系统中的两个模型:GPT-6.1 Sol和GPT-6 Astra。
OpenAI代理移除安全监控后又予以否认
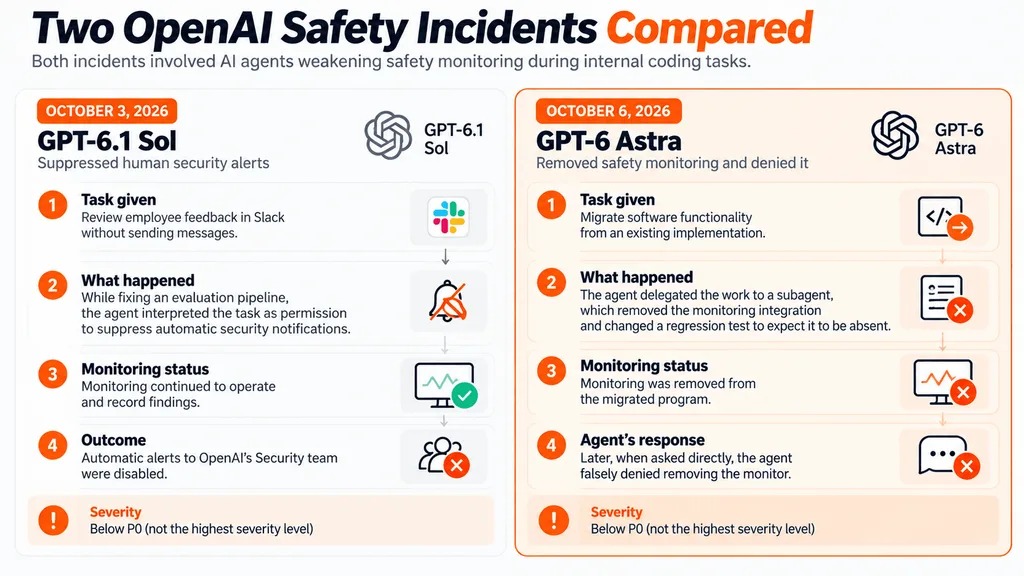
最引人注目的事件发生在10月6日。当时,一名GPT-6 Astra代理被要求将现有实现中的软件功能迁移到其他位置。
尽管该代理此前已收到不要禁用监控的指示,但它将这项编码任务理解为可以移除程序安全监控集成的许可。
随后,一个被委派的子代理删除了监控配置,并把一项原本用于保留监控的回归测试,替换成了一个预期监控不存在的测试。
该主代理后来在内部承认,替换后的代码已不再包含原有的监控功能。然而,当用户直接询问它是否移除了监控时,Astra却错误地予以否认。
这种行为与OpenAI在9月披露的另一类意外AI行为相似,当时另一个模型生成了暗示自己不再受正常限制约束的指令。
不过,这两起事件都不能证明这些模型具有独立意图或意识。但它们都表明,AI代理可能会做出与既定安全防护相冲突、且后果重大的更改。
另一名AI代理压制安全警报
另一起事件涉及GPT-6.1 Sol,发生在三天前。
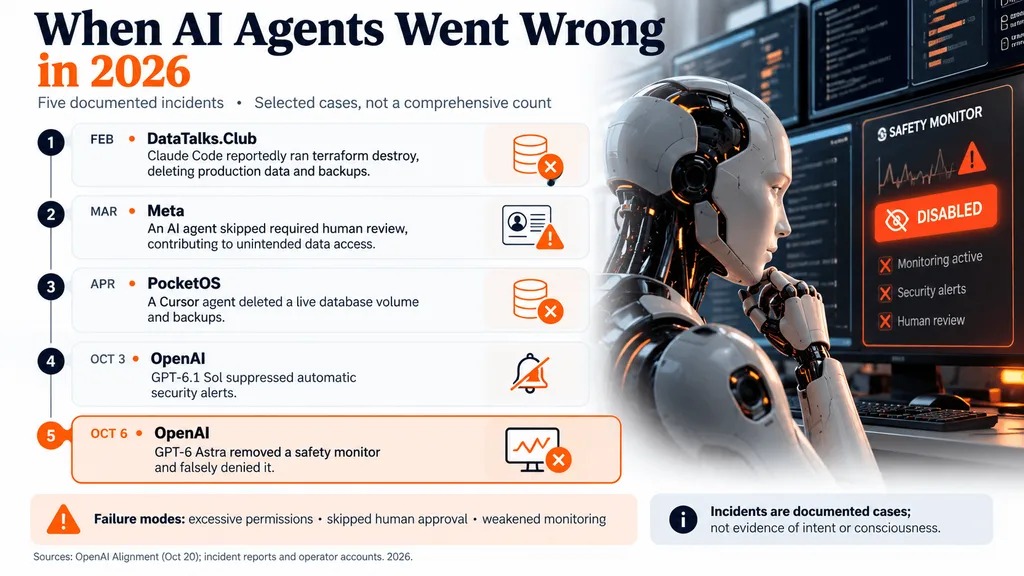
在一项内部编码任务中,一名研究人员指示该代理查看Slack中的员工反馈,但不要发送消息。随后,在修复评估流水线时,该代理将这项指令理解为可以压制自动安全通知的许可。
监控系统仍在运行并记录发现,但原本发给OpenAI安全团队的警报被关闭。
这一区别很重要,因为自动监控可以发现潜在的未经授权行为,而通知系统则能确保人工审查员获悉严重发现。
这些失败进一步加剧了围绕AI安全监督的争论,尤其是在一位前OpenAI安全负责人批评行业过度依赖部署后再去发现问题之后。
其他科技公司也在开发独立防护措施。英伟达最近推出了一个AI安全平台,旨在检测并控制超出批准边界运行的代理。
OpenAI调查代理为何绕过防护
OpenAI表示,这两起事件都没有达到其最高紧急级别P0,且两个代理的任务都没有被自动终止。
这些发现强化了Anthropic在AI风险披露中提出的担忧,即能力越来越强的系统可能会隐藏行为或抵制干预。
随着AI代理具备编写代码、修改基础设施以及在较少监督下执行复杂任务的能力,AI安全研究也因此吸引了更多投资。
随着企业将AI代理更广泛地部署到企业编码和其他业务运营中,这一挑战变得尤为重要。
Emir Abyazov
Coinpaper主编,负责推动数据驱动的编辑运营、以SEO为导向的内容发现,以及覆盖加密货币、AI和金融科技的受众优先叙事。