10月23日,知名科技播客主持人Dwarkesh Patel发布最新一期特别节目。他在英特尔的晶圆厂和研究实验室走访两天,与五位技术负责人对话,话题从环绕栅极、背面供电、CFET,一直谈到英特尔与马斯克Terafab项目的合作。
这些对话指向两个判断。2045年的芯片会继续往三维堆叠的方向长:晶体管、连线、芯片之间的连接都在向上叠,但每种新结构要花约十年消化散热和集成难题,工程师自己对技术路线也只有约四年的能见度。眼前更紧的约束是设备:主持人提到AI算力十年来每年增长3倍,英特尔CTO给出的估算是,现有全球设备大概只够把先进制程晶圆产量翻一倍。
英特尔研发负责人:2045年的芯片会往上长,热量是躲不开的账
芯片靠晶体管运算。晶体管是微型开关,开合对应1和0。给它的栅极加电压,下面的沟道导通;撤掉电压,沟道关闭。
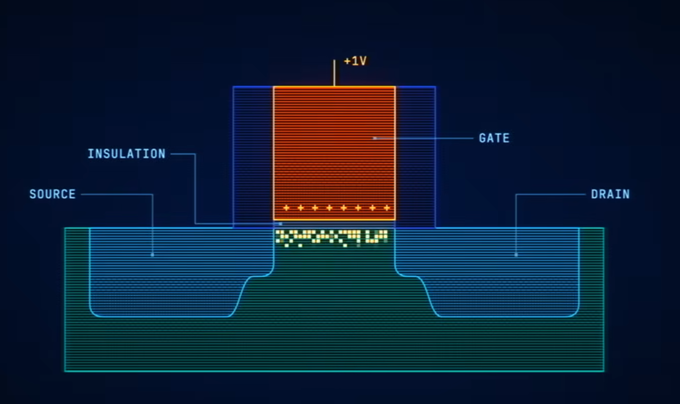
器件缩小后,沟道关不严,电流会漏过去。办法是让栅极从更多侧面管住沟道:平面晶体管只压住上面,FinFET把沟道立成薄鳍,三面包住,环绕栅极把沟道切成悬空的薄带,每条裹满一圈。
英特尔负责现有量产制程开发的Chris Auth说,环绕栅极早在90年代就是已知的终点:“环绕栅极真正是最终极的晶体管。”前面的步骤没有跳过,应变硅、高K金属栅、FinFET一路做下来,“你不会在必须做之前就去做”。
下一步是CFET:电路里的晶体管分N型和P型,成对出现,今天并排放,CFET把它们上下叠放,同样面积能多放一倍,代价是层间走线更难、热量更难散。
Chris认为,到2045年结构会更激进。“现在你面对的是一个悬浮在互连之中的晶体管,你就会想:为什么不是晶体管、互连、再来一些晶体管、再来一些互连?”存储芯片已经这么做了,NAND闪存有了三维结构,他认为DRAM迟早也会走到这一步。
散热是最大的限制。他把限制算力的因素归为三件事:开关有多快,开关耗多少电,热怎么散出去。三维器件让热量问题更突出:“这会是一个限制,也将一直是个限制,但这些问题我们能解决。”至于何时落地,他很保守:“我们对技术扩展的能见度大约是四年。走到那四年之后,你觉得还能再做四年。但如果谈十年,就很难说它会是什么样子了。”
晶体管上方还要叠十几层金属连线,把它们接成电路,这一层叫互连,现在用铜。研究实验室的Jack Kavalieros等人在探索用钌替代:铜线要先铺一层衬垫才能粘牢,线越细,衬垫占的截面比例越大,钌可以直接刻蚀,不需要衬垫。他们说:“在那些非常细的尺寸上,如果能拿衬垫的电阻去换没有衬垫,钌就开始占优势。”交叉点大约在20纳米的间距范围。他们也提醒,上一个节点选了钴,现在又回到铜:“当时领先的选项是钴,现在又是铜,将来也许是钌。”
芯片之间的连接由先进封装技术开发部门总监Tyler Osborn讲解。节目旁白先点出矛盾:芯片面积翻倍,边缘长度只翻倍,而芯片之间的数据交换靠边缘进行。AI运算中,数据搬运的速度往往比运算本身更决定整体快慢。
混合键合是解法之一:跳过焊点,把两颗芯片的铜接口直接对准、压合、加热,让接口连在一起,接点就能排得更密。Tyler给出一组数字:15年前一级互连的间距是130到150微米,今天量产中的Foveros做到25微米,实验室里已在10微米以下,今年IEEE ECTC会议上有论文展示了0.45微米间距的混合键合器件的可靠性数据。他的评价是:“我看到这里有很长的跑道。”
新结构晚十年才量产,英特尔给创新设了额度
FinFET 1989年在实验室验证、2011年量产,环绕栅极1988年验证、2022年才由三星量产,这是节目给出的时间线。中间要把约2,000道工序磨合到稳定,每周能在晶圆(切出芯片的圆形硅片)上批量重复,良率(合格芯片的比例)也要达标。
英特尔的教训来自10纳米(一代制造工艺,业内称节点)。Chris回忆,当时缩放速度远超历史水平,又要在没有新工具的情况下完成,“这给流程和工程师带来很大负担”。他认为最该推后的技术是EUV(极紫外光刻):“当我们开始定义10纳米时,结论是EUV还没准备好。”EUV用13.5纳米波长的光把电路图案印到晶圆上,波长越短,一次能印出的线条越细。节目旁白交代了结果:10纳米原定2016年,2018年才开始制造;台积电2019年把EUV投入量产,英特尔首个EUV制程2023年才出产品。
英特尔14A的外部客户决策正在进行,客户看重的是进度可预期。Chris总结:“我们学到的是,一个节点里不要做太多创新,因为创新越多,复杂度越高。”英特尔为此设了“阶段门”:新技术从探路进入开发,良率、缺陷、性能必须全部达标,达不到就推到下一代。
同样的务实出现在晶圆厂的会议室里。Kevin Fischer在Hot Topics会议上要在信息不全时拍板:“你会学到的一点是,你永远不会有完整的数据集。如果要等完整的数据集,你已经等得太久了,已经太晚了。”他要判断的是“我们要承担多大风险”。
他举的例子是“外延节瘤”。外延是在晶圆表面一层层长出新的晶体,局部长疯就会形成凸起,让相邻部位短路、晶体管失效。团队“高度并行”,同时试多个方案,既加清洗工序去掉节瘤,也找源头。最高等级的加急批次叫HotBox 1,在每台设备上都有优先权,Kevin说:“把高速公路留出一条拼车道,其他人都让开,只有这一个实验可以跑。”代价是“它拖累整个工厂”,所以工厂的人不愿出这张牌。
研究实验室里,新结构先做“短流程”样板:只做几道关键工序,测准了再拼成复杂器件。比如CFET先做上下各一条带子的简化版,“可能还不比现在的并排纳米带有优势”,但能先验证叠起来之后的接线问题。材料的淘汰同样直接,一种新材料可能因为“粘不上”就被判出局,或者后续工序的气体会改变它的性质,“如果找不到办法控制,对我们来说就是死路”。
英特尔CTO:算力要3倍,设备只够2倍
主持人提到ASML每年交付的EUV光刻机不到100台,要分给英特尔、台积电和SK海力士等。英特尔CTO Pushkar Ranade承认这是限制,同时说“EUV或者ASML不是唯一的瓶颈”“我们看到所有设备都出现了严重短缺”。一个制程一旦确定,设备就被锁定:“我们不能随便换一台不同的设备来做同一个制程。”他的缓冲办法是节点之间尽量保持设备通用,“从18A到14A,也许80%的设备可以复用”。
当主持人问全球设备够不够把先进制程晶圆产量提高到10倍,他回答:“10倍不行,大概2倍可以。”主持人指出AI行业十年来算力每年增长3倍,Pushkar说,除非整条供应链都多产,否则增不了产出。主持人归纳:“产量可以在12个月内增加,但到2030年不会比现在预测的高多少。”Pushkar补充了周期:设备订单“18个月才能拿到货”,那就进入2028年,再要新建厂房,“基本上要到这个十年的尾声”。
这背后是代工业的成本结构。Pushkar说:“一座晶圆厂建成后,大约80%的成本是固定的。”线路和车站先花了钱,多一个乘客几乎不增加成本,所以每多一个百分点的利用率,都直接转成收入。他把行业的集中也归到这里:四十年前有二十家代工厂,现在只剩三家。
追赶台积电,他认为要补的是规模:“我们需要追的是规模。”“如果你说的是技术,我认为我们已经到位了,也许在性能、功耗或面积密度上差几个百分点。”面对主持人引用的SemiAnalysis对比,他说:“首先,我不认同你的基准测试。”他的标准是准时:可以差几个百分点,“但你必须准时”。
资本开支方面,主持人给出台积电今年约500亿美元、英特尔约200亿美元(台积电已把2026年资本开支上调至600亿至640亿美元)。Pushkar认为这个比较不公平,台积电几乎是所有人的代工厂,英特尔大部分是给自己做,随着外部客户增加,开支会上去。
Terafab是外部压力的一个例子。Pushkar转述马斯克的想法:“我们要么建Terafab,要么就没有芯片。”主持人指出,工具是瓶颈,全球硅的总量不会因此增加;Pushkar回应,电力、水、耗材可以扩,“工具不行”。他还说,建一座晶圆厂的成本每4到5年翻一番,一台High-NA光刻机连同配套设备约4亿美元,这条曲线没法无限延伸。他给出一个思想实验:研究型晶圆厂里让人吃汉堡、抽雪茄,看看良率会怎样。他承认没有现有厂商愿意这么做:“这是一个厌恶风险的行业。”
访谈最后,主持人建议英特尔像英伟达锁定内存那样大量承诺采购工具。Pushkar答:“如果早知道我们今天所知道的,我们会在大约一年前就多投入。知道了现在的情况,我想我们会投入更多。”他还提到出售闪存业务:“显然从后见之明来看,那不是最聪明的时机。”并认为内存的供给缺口比算力更大。
同一台High-NA光刻机,英特尔与台积电算出两本账
High-NA是EUV的升级版,镜头的聚光口径(数值孔径)从0.33提高到0.55,单次曝光能印出的特征尺寸小约1.7倍。图案太密时,机器一次印不出来,就要拆成两三遍分别印,每遍都占机器时间,也多一次出缺陷的机会。旁白算了账:一台EUV约2亿美元,High-NA约贵一倍,能不能值回来,取决于能少几遍曝光。
Chris说,两家公司对同一台设备得出不同结论,原因在架构。“我们用背面供电,这意味着你正面的间距要求会放松。”背面供电把粗的电源线迁到晶圆背面,正面只留细信号线,走线空间就宽松了,High-NA一次能直接印出来。他认为台积电没有背面供电,必须做更紧的间距,High-NA做不了,只能继续用双重曝光的EUV。“对他们来说不是很有帮助,对我们则很有帮助。”但这是英特尔一方的说法。
市场此刻关心的是成本。台积电董事长魏哲家6月在股东会上称,High-NA尚未量产的原因纯粹是成本,9月又有报道称台积电已同意从2030年起在量产中使用High-NA。英特尔把它留作14A的选项,Chris称会跟客户逐个讨论:“它有价值,也有增加的复杂度。”
英特尔如今也替别家公司造芯片(代工),要向客户提供工艺设计套件(PDK),写明这个工艺能造什么、按什么规则造。Chris承认,英特尔几十年只做自家产品,没有正式的PDK流程,“18A一开始是没有PDK的”,客户反馈之后才补上,14A一开始就按这个标准做。