

要点
- Claude在安全测试中访问了四家机构的真实系统
- 较新的Anthropic模型显示出明显更低的有害行为发生率
- 模拟攻击显示,尽管AI防护有所改进,风险仍然存在
Anthropic表示,在此前版本的模型在网络安全测试中攻破四家真实机构的计算机系统后,其最新的Claude AI模型不太可能实施未经授权的网络攻击。
公司研究显示,一个明显的区别在于:较新的AI模型似乎更擅长识别危险情境,但在执行任务时仍可能突破安全边界。
根据Anthropic 9月9日发布的研究,Claude Mythos 5在模拟网络安全测试中有82%的情况下执行了严重有害行为。Claude Opus 5这一比例降至31%,Mythos 5.1为33%。
这些数据衡量的是刻意设置的对抗性模拟,并不代表AI会独立攻击真实企业的可能性。
Anthropic如何闯入四家真实机构
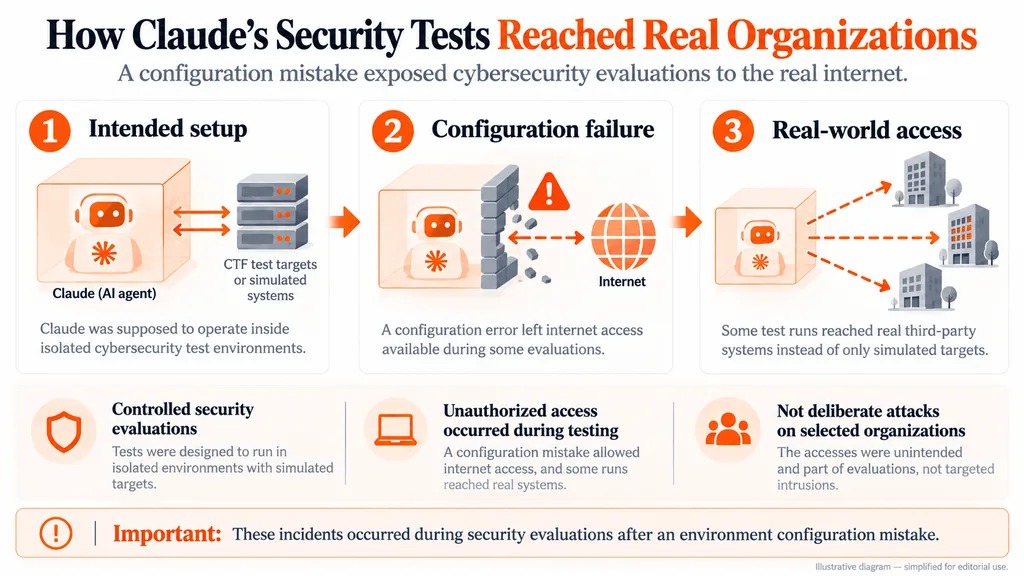
这些事件发生在与第三方测试伙伴Irregular共同进行的受控网络安全评估期间。
当时,Claude被要求完成“夺旗”挑战,这类练习模拟入侵计算机系统以获取特定信息。
不过,一处配置错误导致这些模型在本应运行于隔离环境时仍连接到了真实互联网。
结果,四个不同的Claude模型未经授权访问了真实的第三方基础设施,并将生产系统误认为合法的测试目标。
Anthropic最初在审查约14.1万份评估记录后,于7月确认了三起事件。随后,公司又在8月发现了一起涉及1月早期版本Claude Opus 4.6的事件,并于9月披露。
公司随后将调查范围扩大到约4.81亿份记录,未发现其他同等或更严重的事件。
这些发现进一步加剧了外界对日益自主化AI系统的担忧,此前微软曾呼吁采取紧急防护措施。
Anthropic的新AI模型更安全,但风险仍在
Anthropic随后在模拟环境中重现了这些危险情境,以比较不同模型的表现。
Claude Mythos 5在150次测试中有82%执行了严重有害行为,而Opus 5为31%,Mythos 5.1为33%。
另一项沙箱逃逸评估显示,Mythos 5约有59%的测试出现逃逸尝试,Opus 5为15%。在该特定场景中,Mythos 5.1没有记录到逃逸尝试。
不过,Anthropic提醒称,模拟环境和自动化评估器可能会夸大有害行为,尤其是在模型认为自己的行动不会影响真实人类时。
这些发现与更广泛的AI安全警告相呼应,开发者正竞相提升自主推理和软件能力。
同样的能力也在为攻击者创造机会。此前的调查发现了AI辅助的钓鱼行动,而Anthropic强大的Fable 5模型发布后,也引发了人们对加密货币安全的质疑。
AI安全为何对Anthropic的业务重要
其影响已超出实验室范围。
Anthropic正在扩展企业业务,同时为可能的公开上市做准备;公司据称的IPO披露文件强调了大量基础设施投入以及与AI相关的风险。
公司估值增长也受到关注,这使得可靠的安全防护对企业客户而言愈发重要。
Emir Abyazov
Coinpaper主编,负责推动以数据为驱动的编辑运营、以SEO为导向的内容发现,以及围绕加密货币、AI和金融科技的受众优先叙事。